Introduction & Requirements
월요일 아침, 사용자가 Discover Weekly를 엽니다. 평소 좋아하던 음악과 닮았지만 아직 들어 보지 않은 곡을 재생합니다. 출근길에는 몇 곡을 끝까지 듣고, 업무를 시작한 뒤에는 가사가 없는 음악으로 바꿉니다. 저녁에 Home을 열었을 때도 아침과 같은 추천만 보인다면, 취향은 맞더라도 현재 상황에는 맞지 않을 수 있습니다. 실제 X에서는 Discover Weekly에 다른 아티스트 곡이 섞여 나온다는 불만이 반복됩니다. 랭커만 탓하기 전에 후보 단계의 아티스트 메타데이터 연결부터 확인해야 하는 전형적인 사례입니다.
서버는 이 과정에서 서로 다른 문제를 해결해야 합니다. 이번 주에 제공할 곡 목록을 만들고, 지금 화면에 보여줄 추천을 배치하고, 실제로 들은 음악에서 다음 추천에 사용할 신호를 추출해야 합니다. 곡을 추천했다는 사실, 화면에 보였다는 사실, 재생했다는 사실은 각각 다릅니다.
Spotify는 2025년 Discover Weekly 소개에서 매주 월요일 갱신되는 개인화 플레이리스트라고 설명했습니다. 같은 해 사용자 제어 기능 소개에서는 장르 버튼으로 새로운 30곡 구성을 받을 수 있다고 밝혔고, 2026년 7월 공식 소개에서도 이 장르 제어 기능을 설명했습니다.
따라서 주간 갱신을 지원한다고 해서 일주일 동안 결과가 절대 바뀌지 않는다고 설계하면 안 됩니다. 기본 주간 목록, 사용자가 선택한 조건, 현재 재생 가능 여부를 함께 다뤄야 합니다.
이 글에서 Discover Feed는 음악 발견을 위한 설계 대상의 이름입니다. Spotify가 모든 추천 화면에 사용하는 단일한 내부 제품명이나 서비스명이라는 뜻은 아닙니다. 음악 중심 Home 추천과 Discover Weekly 형태의 주간 목록을 함께 설계하되, 두 화면의 갱신 주기와 추천 단위를 구분하겠습니다.
Spotify Engineering은 2021년 Home 추천을 후보 생성과 순위 결정으로 설명했고, 카드와 여러 카드를 묶은 가로 행을 소개했습니다. 이는 당시 공개된 구조입니다. 현재의 모든 화면과 모델이 그 구현을 그대로 사용한다고 가정하지 않습니다.
2026년에는 생성형 후보 검색과 개인화된 추천 행 생성에 관한 공개 자료도 나왔습니다. 해당 연구는 뒤에서 적용 범위와 함께 살펴보겠습니다. 최신 기능이 등장했다고 해서 카탈로그 검증, 사용자 제어, 지연 시간 제한이 사라지는 것은 아닙니다.
이하의 DB, Queue, API, 모델 구조와 운영 수치는 공개된 제품 동작을 만족시키기 위한 설계 가정입니다. Spotify 내부의 전체 구현과 SLA는 공개 자료만으로 확인할 수 없습니다.
가장 단순한 구현은 사용자가 좋아하는 장르를 저장하고, 그 장르의 인기곡에서 최근 들은 곡을 제외하는 방식입니다. 소규모 서비스에서는 이 구조로 시작할 수 있습니다. 추천이 잘못됐을 때 원인을 설명하기 쉽고, 모델 운영 없이도 사용자 반응을 수집할 수 있기 때문입니다.
사용자와 음악이 많아지면 같은 장르 안에서도 취향이 다르고, 인기곡 위주 추천이 반복되며, 새로운 곡은 반응을 얻을 기회가 부족해집니다. 여기서 후보 검색과 ML 순위 결정을 추가합니다. 동시에 재생 이벤트가 늦거나 중복으로 도착해도 사용자 취향이 왜곡되지 않도록 데이터 경로를 설계해야 합니다.
Functional Requirements
사용자는 자신의 취향과 현재 상황에 맞는 음악 추천을 Home에서 받을 수 있습니다.
사용자는 곡뿐 아니라 앨범, 아티스트, 플레이리스트를 통해 음악을 발견할 수 있습니다.
사용자는 주기적으로 갱신되는 개인화 목록을 열고, 지원하는 장르 조건으로 새로운 구성을 요청할 수 있습니다.
사용자는 곡 저장, 추천 숨김, 취향 반영 제외를 구분해서 사용할 수 있습니다.
시스템은 실제 노출과 재생, 건너뛰기, 저장을 연결해 다음 추천과 모델 학습에 활용합니다.
시스템은 지역별 재생 가능 여부와 콘텐츠 정책, 사용자 제한을 반영합니다.
사용자는 연결이 불안정할 때 이전에 받은 목록을 볼 수 있으며, 다시 연결되면 보류 중인 변경을 동기화할 수 있습니다.
Non-Functional Requirements
다음 수치는 실제 Spotify SLA가 아닌 설계를 위한 가정입니다.
추천 API의 서버 처리 시간은 피크 부하에서 p95 150ms, p99 300ms를 목표로 합니다. 모바일 왕복 시간, 이미지 다운로드, 오디오 시작 시간은 별도로 측정합니다.
정상 추천과 허용된 대체 추천을 합친 조회 가용성은 월간 99.95%를 목표로 합니다. HTTP 성공 여부와 개인화 품질 저하는 별도로 관측합니다.
수집 완료를 응답한 이벤트는 단일 가용 영역 장애 후에도 복구할 수 있도록 복제된 로그에 기록합니다.
온라인 재생 신호는 수집 완료 후 60초 이내에 세션 특성에 반영하는 비율을 99% 이상으로 유지하는 것을 목표로 합니다.
명시적인 추천 차단 변경은 성공 응답 후 시작되는 요청에서 이전 버전을 사용하지 않도록 합니다. 장기 취향 재계산은 비동기로 처리합니다.
주간 목록은 부분 생성 결과를 공개하지 않습니다. 완성된 버전을 게시한 뒤 조회 포인터를 원자적으로 바꿉니다.
학습 배치와 주간 생성 작업이 실시간 추천 자원을 모두 소비하지 않도록 처리량과 자원 풀을 분리합니다.
개인화 데이터에 접근 권한, 보관 기간, 삭제 전파를 적용합니다. 외부 응답에 내부 사용자 벡터나 실험 설정을 노출하지 않습니다.
요청당 추론량, 특성 조회량, 후보 검색량을 제한하고 개인화 품질과 비용을 함께 평가합니다.
Out of Scope
음원 업로드, 트랜스코딩, CDN 배포의 상세 구현
음원 사용료 정산과 구독 결제
광고 경매와 유료 프로모션 최적화
팟캐스트와 오디오북의 전체 추천 모델
자연어 대화형 추천 인터페이스
Spotify Connect의 기기 간 재생 제어 구현
재생 권한 확인과 재생 결과 수집은 추천 설계에 필요한 경계로 포함합니다. 실제 음원 전달은 별도 Playback Service가 담당합니다.
Traffic & Capacity Assumptions
아래 숫자는 실제 이용자 수나 카탈로그 크기를 추정한 값이 아닙니다. 계산 간 관계를 확인하기 위한 가상 서비스 규모입니다. 용량 계산에는 십진 단위인 GB와 TB를 사용합니다.
일간 활성 사용자를 1억 명, 음악 카탈로그를 1억 곡으로 가정하겠습니다. 사용자 한 명이 추천 화면을 하루 평균 10회 요청하면 하루 10억 요청입니다.
평균 약 1만 1,574 QPS이고 피크를 평균의 5배로 잡으면 약 5만 7,870 QPS입니다. 이 요청마다 전체 카탈로그를 검색하거나 사용자 이력을 원본 DB에서 다시 조합할 수는 없습니다. 후보 목록과 사용자 특성을 미리 계산하고 온라인에서는 필요한 부분만 갱신해야 합니다.
사용자가 실제로 본 카드 노출을 하루 200건, 재생 요약과 건너뛰기 등의 이벤트를 하루 150건으로 가정하겠습니다. 합계는 하루 350억 이벤트입니다.
평균 약 40만 5천 이벤트/초이고 피크 5배에서는 약 203만 이벤트/초입니다. 이벤트를 한 건씩 HTTP로 보내는 대신 배치로 전송해야 하지만, 네트워크 요청 수가 줄어도 로그에 기록하고 처리할 이벤트 수는 줄지 않습니다.
이벤트 한 건의 평균 크기를 500바이트로 잡으면 하루 원본 데이터는 약 17.5TB입니다. 복제본 3개를 유지하는 로그의 저장 증가량은 압축과 인덱스 비용을 제외하고 하루 약 52.5TB입니다.
30일 원본은 복제 전 약 525TB입니다. 오래된 이벤트는 Object Storage로 옮기고, 실시간 로그 보관 기간과 학습용 보관 기간을 따로 정해야 합니다. 여기에는 매초 재생 진행 이벤트를 모두 보내는 비용이 포함되지 않으므로, 그런 수집을 추가하면 계산을 다시 해야 합니다.
후보 2,000개를 검색하고 300개에 상세 모델을 적용한다고 가정하겠습니다. 피크에는 초당 약 1억 1,574만 후보와 1,736만 개의 상세 점수 계산을 처리합니다.
HTTP QPS만 보면 수만 단위지만 모델이 평가할 사용자와 항목의 조합은 훨씬 많습니다. 후보 상한, 모델 배치 처리, 항목 표현 사전 계산이 필요한 이유입니다. GPU 수는 이 숫자만으로 정하지 않고 실제 모델의 처리량과 대기 시간을 측정해서 결정합니다.
사용자별 후보 2,000개를 후보당 24바이트로 저장하면 1억 명에 대해 약 4.8TB입니다. 활성 사용자의 세션 요약을 평균 2KB로 유지하면 약 200GB입니다.
모든 후보와 특성을 비싼 메모리에 넣는 설계는 재검토해야 합니다. 자주 접속하는 사용자의 데이터는 메모리에 두고, 나머지는 저비용 저장소에서 가져오는 계층 구성이 필요합니다. 직렬화, 키, 복제 비용은 별도 여유로 더합니다.
주간 목록 생성 대상을 1억 명, 생성 창을 24시간으로 잡으면 초당 약 1,157개의 목록을 완성해야 합니다. 한 목록에서 후보 2,000개를 검토한다면 평균 약 231만 후보 평가/초가 추가됩니다.
주간 작업을 월요일 자정에 한꺼번에 시작하면 조회와 생성 부하가 겹칩니다. 지역별 게시 시각 전에 나눠 계산하고, 온라인 추론과 별도 용량을 확보하겠습니다.
추천 응답을 평균 15KB로 잡으면 하루 약 15TB, 피크에는 약 868MB/초의 응답 대역폭이 필요합니다.
앨범 이미지와 음원은 이 응답에 넣지 않습니다. 메타데이터와 이미지 식별자만 전달하고 미디어 전달 경로를 분리해야 추천 API가 음원 트래픽에 영향을 덜 받습니다.
Problem Framing
재생할 가능성과 새로 발견할 가치는 다릅니다
사용자가 이미 매일 듣는 곡은 재생 확률이 높을 수 있습니다. 이 곡만 추천하면 단기 재생 지표는 좋아지지만 발견 기능의 역할은 줄어듭니다.
이 설계에서는 아직 익숙하지 않은 음악을 시도하고, 만족스러운 재생이나 저장으로 이어지며, 나중에 다시 찾아 듣는 경험을 목표로 두겠습니다. 추천으로 발생한 재생 증가와 원래 들었을 재생을 구분하려면 사용자 단위 실험이 필요합니다.
신곡과 새로운 발견도 구분해야 합니다. 오래전에 발매된 곡이라도 사용자에게는 처음일 수 있습니다. 발매일, 최근 청취 여부, 아티스트 친숙도는 서로 다른 특성입니다.
Spotify의 공개 추천 설명도 검색, 청취, 건너뛰기, 저장을 취향을 이해하는 신호로 소개하며 다음 클릭만 최적화하는 접근을 지향하지 않는다고 설명합니다. 다만 실제 학습 목표와 각 신호의 계수는 공개된 것으로 가정하지 않습니다.
곡, 카드, 추천 행을 구분합니다
Discover Weekly 안에서는 어떤 곡을 어떤 순서로 배치할지 결정합니다. Home에서는 어떤 플레이리스트나 앨범 카드를 보여줄지, 어떤 주제의 가로 행을 위에 놓을지도 결정합니다.
앨범 카드를 눌렀다는 사건과 그 안의 곡을 오래 들었다는 사건을 같은 라벨로 처리하면 안 됩니다. 카드에는 콘텐츠를 열거나 재생을 시작할 확률을 예측하는 모델을 두고, 곡에는 실제 청취와 저장을 예측하는 모델을 둡니다. 여러 카드를 묶은 행에는 항목 간 중복과 주제 일치 여부도 필요합니다.
초기에는 추천 행을 소수의 고정된 주제로 만들고 카드 순위만 개인화할 수 있습니다. 행 종류와 화면 배치가 늘어날 때 행 수준의 모델과 목록 전체를 조정하는 정책을 추가하겠습니다.
Labels와 피드백 해석
제공한 목록을 모두 노출로 세지 않습니다
서버가 카드 30개를 반환해도 사용자가 화면에서 본 것은 6개뿐일 수 있습니다. 따라서 서버 응답은 제공 기록으로 남기고, 실제 화면 표시 이벤트는 클라이언트에서 별도로 수집합니다.
예를 들어 카드 면적의 절반 이상이 1초 동안 보인 경우를 노출로 인정할 수 있습니다. 이는 이 설계의 측정 규칙이며 Spotify의 정의가 아닙니다. 클라이언트 버전과 표시 기준을 함께 기록해야 측정 방식 변경을 모델 개선으로 오해하지 않습니다.
재생 목록은 화면에 곡이 보이지 않아도 자동으로 다음 곡을 재생할 수 있습니다. 이런 재생에는 카드 노출을 임의로 만들어 붙이지 않고, 목록 진입과 재생 시작의 출처를 기록합니다.
명시적인 행동과 관찰된 행동을 함께 봅니다
저장과 특정 곡 숨김은 사용자가 직접 선택한 행동입니다. 오래 듣기와 건너뛰기는 관찰된 행동입니다. 같은 5초 재생이라도 사용자가 다음 곡 버튼을 눌렀는지, 네트워크가 끊겼는지에 따라 의미가 달라집니다.
재생 요약에는 실제 들은 시간, 곡 길이, 사용자의 건너뛰기, 버퍼링, 출력 기기 변경, 재생 종료 이유를 넣습니다. 사용자가 실제로 소리를 들었는지는 완벽하게 관측할 수 없으므로 재생 시간은 만족의 대리 지표로 취급합니다.
완주율만 최적화하면 짧은 곡에 유리할 수 있고, 재생 시간만 최적화하면 긴 곡에 유리할 수 있습니다. 곡 길이와 진입 방식에 따른 차이를 반영하고 저장, 명시적 부정 반응, 이후 재방문을 함께 평가하겠습니다.
라벨마다 관찰 기간을 둡니다
즉시 건너뛰기는 빠르게 관찰되지만 저장과 다시 듣기는 며칠 뒤에 생길 수 있습니다. 최근 제공 기록에 저장 이벤트가 아직 없다는 이유로 바로 음성 라벨을 붙이면, 반응할 시간이 없었던 항목을 학습에서 불리하게 만듭니다.
이 설계에서는 재생 결과를 위한 짧은 관찰 기간과 다시 듣기를 위한 7일 관찰 기간을 따로 둡니다. 관찰 기간이 끝나지 않았거나 재생 결과가 누락된 표본은 완료된 음성 표본과 구분합니다. 구체적인 기간은 제품 사용 패턴을 보고 조정합니다.
학습 시점에는 미래의 저장 여부를 라벨로 사용할 수 있습니다. 그러나 추천 당시 입력 특성에 미래의 저장 횟수나 나중에 계산된 인기 순위가 들어가면 정보 누출이 됩니다. 특성에는 사건 발생 시각뿐 아니라 시스템이 그 값을 알게 된 시각도 보관하겠습니다.
취향 반영 제외와 추천 차단은 다릅니다
Spotify Help Center는 플레이리스트나 곡을 취향에서 제외하면 과거와 미래 청취가 추천에 미치는 영향이 줄어든다고 설명합니다. 제외한 플레이리스트 밖에서 같은 곡을 듣는 경우는 별도로 취급하며, 반영에는 최대 48시간, Discover Weekly에는 다음 주까지 걸릴 수 있다고 안내합니다. 이 동작은 특정 목록에서 곡을 숨기는 기능과 다릅니다.
따라서 모든 사용자 제어를 하나의 dislike 값으로 저장하지 않습니다. 특정 목록에서의 숨김, 설계상 명시적으로 제공하는 추천 차단, 취향 학습에서의 제외를 분리합니다.
취향에서 제외한 곡은 사용자가 싫어하는 곡이라는 뜻이 아닙니다. 수면 음악을 계속 들으면서도 다른 추천에 영향을 주지 않게 하고 싶을 수 있습니다. 제외 신호를 일괄적인 음성 라벨로 바꾸면 사용자의 의도를 잘못 학습하게 됩니다.
노출 편향을 통제합니다
기존 모델은 자신이 높은 점수를 준 곡을 주로 보여줍니다. 이 기록만으로 학습하면 노출 기회가 없었던 곡이 계속 불리해질 수 있습니다. 미노출 곡은 사용자에게 거절당한 곡이 아닙니다.
검색 모델은 노출되지 않은 항목을 대조 학습의 샘플로 사용할 수 있지만, 이를 실제 싫어요와 같은 라벨로 해석하지 않습니다. 샘플링 분포와 인기도 편향을 관리하고, 평가에는 가능한 한 실제 노출과 성숙한 반응 기록을 사용합니다.
안전한 후보 안에서 제한적인 무작위 탐색을 수행할 때는 해당 항목이나 목록 구성이 선택될 확률을 기록합니다. 이를 이용한 역확률 가중 평가는 작은 확률 때문에 분산이 커질 수 있으므로 가중치 상한과 유효 표본 수를 함께 확인합니다. 한 번도 선택될 가능성이 없었던 후보의 효과를 이런 보정으로 알아낼 수는 없습니다.
음악은 앞에서 들은 곡에 따라 다음 곡의 반응도 달라집니다. 항목별 선택 확률을 기록했다고 전체 목록의 효과를 독립적으로 평가할 수 있는 것도 아닙니다. Spotify가 2020년에 공개한 순차적 목록 평가 연구 역시 이런 상호작용을 다룹니다. 이 설계에서는 해당 한계를 고려해 오프라인 평가를 후보 선별에 사용하고, 최종 판단은 사용자 단위 A/B 실험으로 내리겠습니다.
Core Entities & Data Modeling
원본 상태와 관찰 데이터를 분리합니다
사용자가 저장하거나 명시적으로 변경한 제어 설정은 성공 응답 뒤에 사라져서는 안 됩니다. 같은 변경이 재시도돼도 한 번 적용된 결과를 돌려줘야 합니다. 이 데이터는 조건부 갱신과 고유 제약을 사용할 수 있는 RDBMS에 둡니다.
노출과 재생 이벤트는 양이 많고 나중에 다시 처리할 필요가 있습니다. Event Stream에 기록하고 Object Storage로 보관합니다. 모든 이벤트를 사용자 설정과 같은 트랜잭션에 넣지 않습니다.
카탈로그의 원본 메타데이터와 지역별 제공 권한은 Catalog Service가 관리합니다. 추천 경로는 필요한 값을 조회용 데이터로 복제해 사용하지만, 최종 재생 허용은 Playback Service가 현재 권한을 확인해서 결정합니다.
주요 식별자는 다음과 같이 구분하겠습니다.
request_id , 한 번의 API 처리 시도
decision_id , 특정 입력과 모델 조합으로 만든 추천 결정
snapshot_id , 페이지 이동 중 유지하는 추천 목록 버전
impression_id , 클라이언트가 관측한 개별 화면 노출
playback_id , 한 번 시작된 재생 세션
event_id , 재전송해도 바뀌지 않는 이벤트 식별자
edition_id , 게시 가능한 주간 목록 버전
control_version , 사용자가 명시적으로 변경한 제어 설정 버전
bundle_id , 서로 호환되는 모델과 특성, 임베딩, 인덱스 조합
같은 HTTP 요청을 다시 보내면 request_id는 달라질 수 있지만 이벤트의 event_id는 유지합니다. 같은 곡을 다시 재생하는 경우에는 새로운 playback_id를 만들어 정상적인 반복 청취와 중복 전송을 구분합니다.
제어 상태와 멱등성 기록
다음은 PostgreSQL 기준의 교육용 스키마입니다. 예제를 짧게 유지하기 위해 제어 규칙을 JSON 문서에 넣었습니다. API에서 규칙 종류, 허용 대상, 문서 크기를 검사하고, 사용자별 규칙이 많아지면 별도 관계 테이블로 분리합니다.
CREATE TABLE user_controls (
    user_id UUID PRIMARY KEY,
    version BIGINT NOT NULL DEFAULT 1 CHECK (version >= 1),
    document JSONB NOT NULL DEFAULT '{}'::jsonb,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    updated_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    CHECK (jsonb_typeof(document) = 'object')
);

CREATE TABLE control_commands (
    command_id UUID PRIMARY KEY,
    user_id UUID NOT NULL REFERENCES user_controls(user_id),
    idempotency_key TEXT NOT NULL,
    request_body JSONB NOT NULL,
    response_body JSONB NOT NULL,
    applied_version BIGINT NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (user_id, idempotency_key)
);

CREATE TABLE outbox_events (
    event_id UUID PRIMARY KEY,
    aggregate_id UUID NOT NULL REFERENCES user_controls(user_id),
    aggregate_version BIGINT NOT NULL,
    command_id UUID NOT NULL REFERENCES control_commands(command_id),
    event_type TEXT NOT NULL,
    idempotency_key TEXT NOT NULL,
    payload JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    published_at TIMESTAMPTZ,
    UNIQUE (aggregate_id, event_type, idempotency_key)
);created_at은 처음 만들어진 시각이고 updated_at은 마지막 변경 시각입니다. 둘을 분리해야 오래된 계정의 최근 제어 변경과 새로 생성된 상태를 구분할 수 있습니다.
version은 두 기기가 같은 이전 상태를 수정할 때 한쪽 변경이 조용히 사라지는 것을 막습니다. idempotency_key는 같은 요청의 재전송을 처리하고, 버전은 서로 다른 요청의 충돌을 처리합니다. 둘은 다른 문제를 해결합니다.
추천 스냅샷과 주간 목록
화면 조회용 스냅샷에는 순서가 결정된 항목, 추천 결정 식별자, 모델 조합, 생성 시각, 제어 버전을 둡니다. 카드의 표시용 데이터는 Cache나 분산 Key-Value Store에 두고, 분석에 필요한 제공 기록은 이벤트로 남깁니다.
주간 목록은 불변 Manifest와 작은 게시 포인터로 나누겠습니다. Manifest는 순서가 확정된 곡 목록을 담고 Object Storage에 저장합니다. 게시 포인터는 사용자, 주차, 장르 조건별 현재 edition_id를 가리키며 RDBMS에서 조건부로 변경합니다.
{
  "edition_id": "edition_20260928_u42_g2",
  "user_id": "u42",
  "period_start": "2026-09-28",
  "variant_key": "genre_jazz",
  "generation": 2,
  "status": "ready",
  "input_cutoff": "2026-09-27T12:00:00Z",
  "control_version": 18,
  "bundle_id": "music_bundle_52",
  "manifest_key": "editions/u42/20260928/jazz/2.json"
}
이 JSON의 짧은 식별자는 설명용이며, 실제 DB에는 스키마에서 정한 UUID를 사용합니다.
상태는 pending, building, ready, published, failed로 구분합니다. 성공 여부만 저장하면 생성 중인지, 검증이 끝났는지, 사용자에게 공개됐는지 알 수 없습니다.
동일한 사용자, 주차, 조건, 생성 번호에는 고유 제약을 둡니다. Manifest의 항목 수, 중복, 체크섬과 읽기 가능 여부를 검사한 뒤 ready로 전환합니다. 게시 포인터 변경에는 현재 포인터 버전과 생성 번호를 확인해 오래된 Worker가 새 결과를 덮어쓰지 못하게 합니다.
저장소별 책임
Online Feature Store에는 최근 장르 분포, 최근 건너뛰기 요약, 현재 세션의 사용자 표현을 둡니다. 값과 함께 계산 시각, 데이터 도착 기준 시각, 특성 스키마 버전을 저장해야 오래된 값을 정상 값으로 오해하지 않습니다.
Vector Index에는 후보 검색용 항목 임베딩을 둡니다. 아티스트 관계나 함께 등장하는 곡의 연결은 별도 그래프 또는 Key-Value 인접 목록으로 관리할 수 있습니다. 초기에는 관계를 배치로 계산해 저장하는 방식이면 충분하며, 관계가 있다고 반드시 전용 Graph DB가 필요한 것은 아닙니다.
Analytics 저장소에는 노출, 제공 기록, 재생 결과, 실험 배정, 버전 정보를 결합한 학습용 데이터를 둡니다. 온라인 API가 이 저장소의 대규모 조인을 기다리지 않도록 합니다.
RDBMS에서 제외할 데이터
노출 이벤트와 재생 진행 데이터는 빈도가 높고 대부분 추가 기록입니다. OLTP 테이블에 모두 넣으면 설정 변경과 같은 작은 트랜잭션이 대량 쓰기, 인덱스 유지, 복제 부하와 경쟁하게 됩니다. Event Stream과 Object Storage에서 수집하고 분석합니다.
음원, 앨범 이미지, 학습 모델 파일은 큰 바이너리입니다. Object Storage에 보관하고 원본 DB에는 위치와 버전만 둡니다.
항목 벡터와 후보 검색 결과는 조회 방식이 다릅니다. 벡터는 검색 인덱스에, 사용자별 후보는 Key-Value Store에 둡니다. 일시적으로 재생성할 수 있는 후보 목록을 사용자 제어 변경과 같은 영속성 수준으로 관리할 필요는 없습니다.
초 단위 세션 요약은 Online Feature Store에 둡니다. 다만 메모리 데이터만으로 사용자 취향을 영구 보존하지 않고, 유실되면 재생 로그와 장기 특성에서 복구할 수 있게 합니다.
API Signatures
여기서 제시하는 경로는 실제 Spotify API가 아닌 설계 예시입니다. 사용자는 인증 토큰에서 식별하고, 요청 본문에 들어온 임의의 user_id를 신뢰하지 않습니다.
추천 목록 조회
GET /v1/discovery/feed?surface=home&limit=30
Authorization: Bearer <access_token>
X-Session-Id: session_83
X-Min-Control-Version: 18
{
"decision_id": "decision_d91",
"snapshot_id": "snapshot_s20",
"control_version": 18,
"items": [
{
"item_id": "playlist_p18",
"item_type": "playlist",
"shelf_id": "shelf_new_artists",
"position": 0,
"reason_code": "new_to_you",
"exposure_token": "signed_context"
}
],
"next_cursor": "opaque_signed_cursor",
"degraded": false
}응답은 필요한 후보 검색, 순위 결정, 제어 적용까지 기다립니다. 새 모델 학습이나 주간 목록 전체 생성은 기다리지 않습니다.
Cursor에는 사용자, Snapshot, 다음 위치, 만료 시각을 서명해서 연결합니다. 다음 페이지마다 최신 점수로 다시 정렬하면 앞 페이지의 항목이 반복되거나 빠질 수 있으므로 같은 Snapshot을 이어서 읽습니다.
사용자가 제어를 변경하면 Snapshot은 유지하더라도 현재 제어를 다시 적용합니다. 차단된 항목을 제거한 만큼 다음 위치를 더 읽되 처리량 상한을 둡니다. Snapshot이 만료되면 새 목록을 시작하라는 응답을 주고 클라이언트가 현재 보고 있던 화면을 즉시 초기화하지 않도록 합니다.
X-Min-Control-Version은 동일 기기의 변경 직후 읽기를 돕습니다. 다른 기기에서 바꾼 설정까지 보장하려면 이것만으로 부족하므로, 서버는 최신 제어 버전을 일관되게 읽을 수 있는 Policy Service를 사용합니다.
명시적인 제어 변경
PUT /v1/me/recommendation-controls
Authorization: Bearer <access_token>
Idempotency-Key: 34cc44cf-1f91-4ce2-bb14-80a2121c83a4
If-Match: "17"
Content-Type: application/json

{
  "excluded_from_taste": [
    {"type": "playlist", "id": "playlist_sleep"}
  ],
  "blocked_recommendations": [
    {"type": "track", "id": "track_t10"}
  ]
}
{
"control_version": 18,
"state": "applied",
"taste_rebuild": "pending"
}이 API는 예제에서는 전체 제어 문서를 교체합니다. 클라이언트는 현재 문서를 읽고 수정한 뒤 버전을 보내야 합니다. 부분 변경 API를 추가하더라도 멱등성과 버전 확인은 유지합니다.
applied는 원본 제어가 저장됐다는 뜻입니다. 추천 차단은 이후 요청에서 적용하지만 장기 취향 재계산은 아직 진행 중일 수 있습니다. 이 차이를 응답에서 드러내야 사용자가 저장 성공과 모델 반영 완료를 혼동하지 않습니다.
같은 키로 다른 본문을 보내면 409를 반환합니다. 다른 기기가 먼저 변경해 If-Match가 맞지 않으면 412를 반환하고 현재 상태를 다시 읽게 합니다. 재전송된 동일 요청은 현재 버전이 더 높아졌어도 원래 결과를 반환합니다.
이벤트 배치 수집
POST /v1/listening-events:batch
Authorization: Bearer <access_token>
Content-Type: application/json

{
  "events": [
    {
      "event_id": "event_e72",
      "type": "playback_summary",
      "playback_id": "playback_b19",
      "summary_revision": 3,
      "decision_id": "decision_d91",
      "exposure_token": "signed_context",
      "source_item_id": "playlist_p18",
      "track_id": "track_t25",
      "occurred_at": "2026-09-28T17:00:00Z",
      "listened_ms": 85000,
      "end_reason": "user_skip"
    }
  ]
}
{
"accepted_event_ids": ["event_e72"],
"rejected_events": [],
"durably_received": true
}수집기는 인증, 크기, 스키마를 검사하고 복제된 로그에 기록한 항목만 수락했다고 응답합니다. 이 응답이 Feature Store 반영이나 학습 완료를 뜻하지는 않습니다.
부분 성공이면 이벤트별 결과를 돌려주고 실패한 항목만 재시도합니다. 타임아웃으로 결과를 모르면 동일한 event_id로 다시 보냅니다. 피드백 처리기가 중복을 제거하므로 재전송 횟수가 사용자 선호의 크기로 바뀌지 않습니다.
주간 목록과 장르 변경
GET /v1/discovery/weekly?period=2026-09-28&genre=jazz
Authorization: Bearer <access_token>
이미 게시된 버전이 있으면 즉시 반환합니다. 장르 조건에 맞는 버전이 없다면 별도의 멱등성 있는 생성 요청으로 작업을 만들고 202와 job_id를 반환합니다. 조회 요청을 길게 붙잡은 채 모델 계산을 기다리지 않습니다.
클라이언트는 기존 목록을 유지하면서 새 구성을 준비 중이라고 표시합니다. 준비가 끝나면 새 edition_id를 명시적으로 받아 교체합니다. 이 비동기 동작은 우리 설계의 선택이며, 실제 Spotify의 내부 API나 갱신 구현을 설명하는 것은 아닙니다.
전체 구조와 데이터 흐름
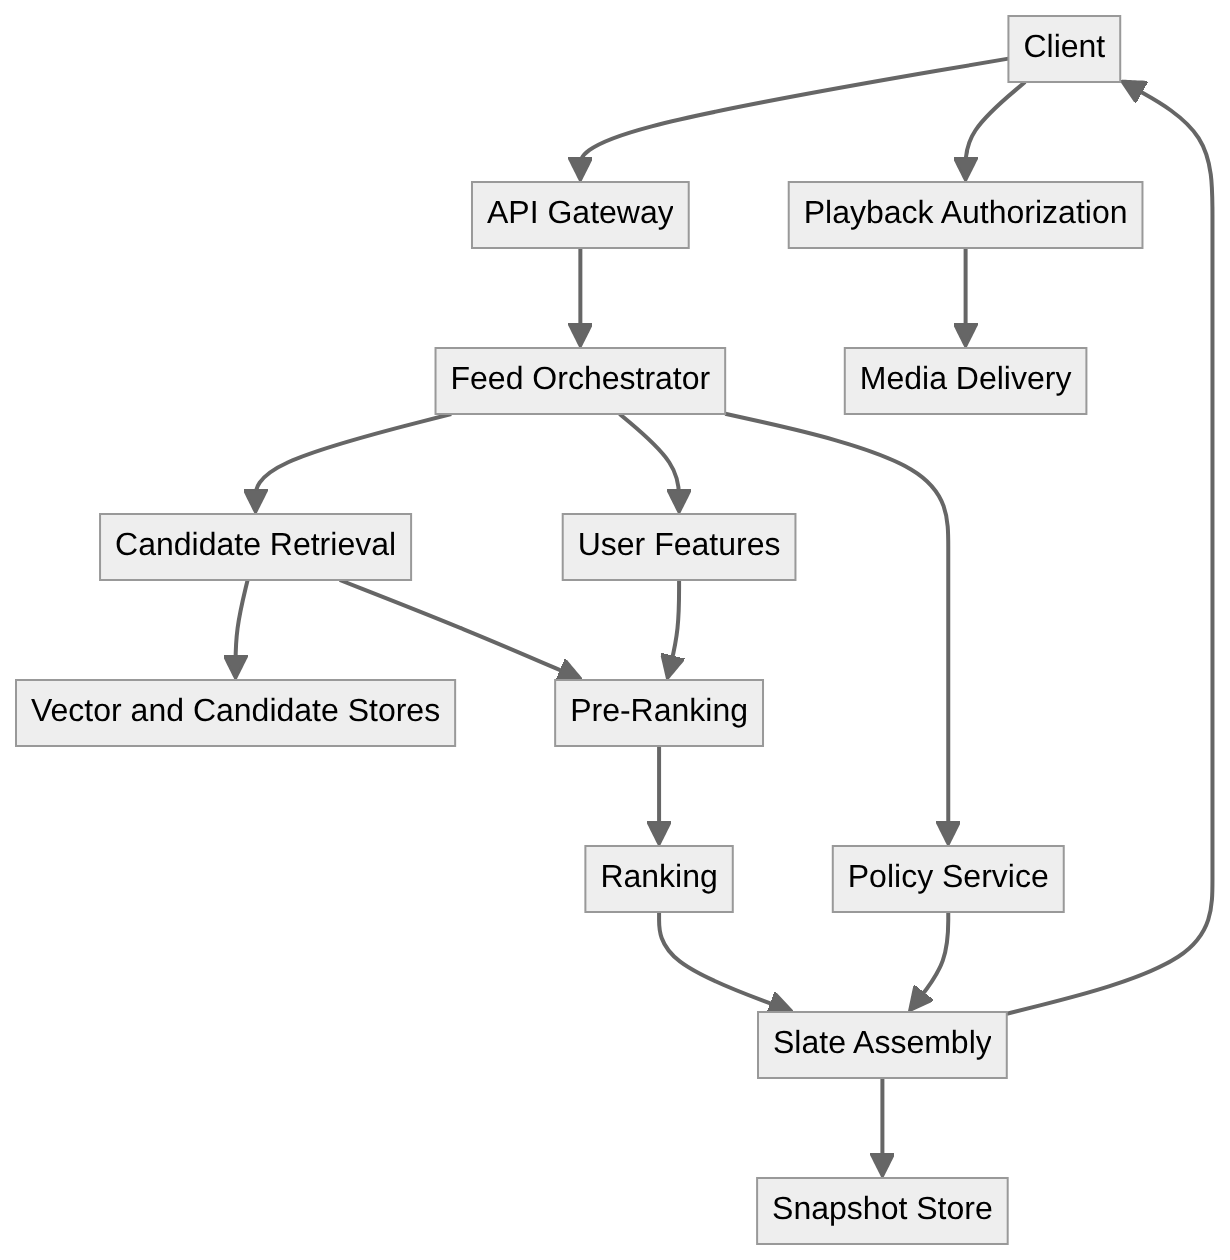
온라인 추천 경로