

입력은 즉시 반영하고 필요한 요청만 보내며, 늦게 도착한 응답이 현재 검색어와 사용자의 선택을 바꾸지 않도록 설계하는 프론트엔드 시스템
Introduction & Requirements
사용자가 검색창에 react를 입력합니다.
입력창 아래에는 react tutorial, react hooks, react server components 같은 검색어가 나타납니다. 사용자는 방향키로 원하는 항목을 고르고 Enter를 누릅니다.
사용자가 보는 화면은 짧은 입력창과 목록이지만, 그동안 여러 작업이 겹쳐서 진행됩니다.
브라우저는 입력을 화면에 반영합니다. 서버에 검색어를 보내고, 이전에 조회한 결과가 있는지 확인합니다. 서버는 후보를 찾아 순서를 정한 뒤 반환합니다. 사용자가 다시 입력하면 아직 처리 중인 요청의 의미도 달라집니다.
여기서 이전 요청이 늦게 도착했다고 해보겠습니다.
사용자는 이미 react를 입력했는데, 조금 전에 보낸 re의 결과가 나중에 도착합니다. 브라우저가 응답을 받은 순서대로 목록을 교체하면 현재 입력과 관계없는 후보가 화면에 나타납니다.
이번에는 사용자가 목록을 닫았다고 해보겠습니다.
Escape를 눌러 목록을 닫았는데, 진행 중이던 요청이 완료되면서 목록이 다시 열립니다. 서버 응답은 정상이어도 사용자의 마지막 행동과 맞지 않는 화면입니다.
한국어 입력에서는 또 다른 문제가 생깁니다.
사용자가 한 글자를 조합하는 동안 검색을 보내거나, 한글 조합을 확정하려고 누른 Enter를 검색 실행으로 처리하면 아직 입력하지 않은 검색어로 화면이 이동할 수 있습니다.
따라서 이번 설계에서는 요청을 빠르게 보내는 것보다 먼저 다음 관계를 지키겠습니다.
화면에 표시한 후보는 현재 입력과 현재 검색 범위에 속해야 합니다. 사용자가 목록을 닫거나 다른 검색으로 이동했다면 이전 작업은 그 화면을 다시 바꿀 수 없어야 합니다.
Google 스타일의 검색어 자동완성을 예시로 사용하겠습니다. 사용자는 후보를 선택할 수도 있고, 목록에 없는 검색어를 그대로 제출할 수도 있습니다. 아래의 구조와 수치는 이러한 경험을 만들기 위한 설계 가정입니다.
Functional Requirements
사용자는 글자를 입력하는 즉시 입력창에서 확인할 수 있어야 하며, 입력 중 관련된 검색어 후보를 받을 수 있어야 합니다.
사용자는 마우스, 터치, 키보드로 후보를 선택할 수 있어야 하고, 후보를 선택하지 않고 현재 검색어를 제출할 수도 있어야 합니다.
새로운 입력이 발생하면 이전 검색의 결과가 현재 목록을 덮어쓰지 않아야 합니다.
한국어와 일본어처럼 조합 과정이 있는 입력을 지원하고, 조합 확정과 검색 실행을 구분해야 합니다.
후보 조회에 실패하더라도 사용자가 입력한 검색어를 유지하고 일반 검색을 실행할 수 있어야 합니다.
스크린 리더 사용자가 검색창의 이름, 목록의 열림 상태와 현재 탐색 중인 후보를 인식할 수 있어야 합니다.
Non-Functional Requirements
입력 자체의 시각적 반영은 p95 50ms 이내를 목표로 하며, 후보 조회를 기다리는 시간과 분리해서 측정합니다.
입력이 멈춘 뒤 현재 검색어에 맞는 후보가 표시되기까지 정상 네트워크에서 p95 400ms 이내를 목표로 합니다.
화면에는 최대 8개의 후보를 표시하고, 메모리 캐시의 항목 수와 후보 응답 크기에 상한을 둡니다.
다른 계정, 언어, 검색 범위의 캐시나 진행 중인 응답이 현재 검색에 섞이지 않아야 합니다.
조회가 지연되거나 실패해도 입력창과 검색 제출 동작이 멈추지 않아야 합니다.
50ms와 400ms는 이 글의 설계 목표입니다. 실제 서비스의 공개 SLA가 아닙니다.
또 400ms에는 입력 대기 정책과 네트워크, 서버 처리, 브라우저 반영 시간이 함께 들어갑니다. 서버 API가 빠르다는 이유만으로 사용자가 후보를 빨리 보았다고 판단하지 않습니다.
Out of Scope
최종 검색 결과 페이지의 전체 랭킹과 문서 검색 엔진 내부는 직접 구현하지 않습니다.
자동완성 후보를 학습하는 모델과 학습 파이프라인은 제외하되, 후보 생성과 필터링에 필요한 서버 계약은 설명합니다.
음성 입력의 인식 엔진은 제외하고, 확정된 텍스트가 검색창에 들어온 이후의 흐름을 다룹니다.
Traffic & Capacity Assumptions
DAU를 100만 명, 사용자당 하루 검색 세션을 6회로 가정하겠습니다.
검색 세션 하나에서 입력값이 평균 12번 바뀐다면, 모든 입력마다 요청할 경우 하루 7,200만 건의 자동완성 요청이 발생합니다.
입력 대기와 조합 처리를 적용한 뒤 세션당 실제 조회 후보가 평균 3번으로 줄었다고 가정하면 하루 1,800만 건입니다. 이 중 메모리 캐시가 30퍼센트를 처리하면 서버 요청은 하루 약 1,260만 건이 됩니다.
Daily search sessions

1,000,000 users x 6
= 6,000,000 sessions

Without scheduling

6,000,000 x 12
= 72,000,000 requests

After input scheduling

6,000,000 x 3
= 18,000,000 lookups

After 30 percent client cache hits

18,000,000 x 0.7
= 12,600,000 server requests

Average server rate

12,600,000 / 86,400
= about 146 requests per second

Peak server rate

Average x 10
= about 1,460 requests per second
세션당 조회 3번과 캐시 적중률 30퍼센트는 효과를 미리 보장하는 숫자가 아닙니다. 실제 입력 간격과 검색어 반복 정도를 측정해서 바꿔야 하는 가정입니다.
이 계산이 필요한 이유는 debounce와 캐시가 서로 다른 구간에서 요청량을 줄이기 때문입니다.
debounce는 아직 보낼 필요가 없는 입력을 합칩니다. 캐시는 보내려고 정한 조회 중 이미 가지고 있는 결과를 재사용합니다.
응답이 평균 2KB라면 본문만 하루 약 25.2GB입니다. 후보마다 큰 이미지와 설명을 추가해 평균 20KB가 되면 약 252GB가 됩니다.
따라서 자동완성에서는 후보 개수뿐 아니라 각 후보에 담는 필드도 제한합니다. 사용자가 다음 검색어를 고르는 데 필요하지 않은 상세 데이터까지 매 입력마다 내려주지 않습니다.
지연 예산을 나눠서 봅니다
입력이 멈춘 뒤 150ms를 기다리고, 네트워크와 서버 처리가 180ms, 브라우저 반영이 20ms 걸리는 상황을 생각해보겠습니다.
이 숫자는 한 요청의 예시입니다. 각 구간의 p95를 더하면 전체 p95가 된다는 뜻은 아닙니다.
캐시가 맞으면 네트워크 요청과 debounce 대기를 생략할 수 있습니다. 반면 느린 모바일 네트워크에서는 서버 처리 시간을 줄여도 왕복 지연 때문에 목표를 넘을 수 있습니다.
그래서 입력 반응, 후보 표시, 실제 검색 완료를 각각 다른 경험으로 측정합니다.
Core Entities & Data Modeling
검색창의 텍스트 하나만 상태로 관리하면 부족합니다.
사용자가 편집 중인 원문, 서버에 전달할 검색어, 현재 후보가 만들어진 검색 조건, 키보드로 탐색 중인 후보를 구분해야 합니다.
입력 원문은 사용자가 보는 값입니다. 공백이나 조합 중인 문자를 임의로 바꿔 다시 입력창에 쓰지 않습니다.
검색용 값은 API 계약에 맞게 정리한 값입니다. 이번 예제에서는 Unicode NFC 정규화와 양끝 공백 제거만 적용합니다. 정규화는 서로 다른 코드 조합으로 표현된 문자를 같은 형태로 비교할 때 사용할 수 있습니다. )
대소문자 변환이나 내부 공백 제거까지 무조건 적용하지는 않습니다. 검색 서비스가 두 입력을 같은 의미로 취급한다는 계약이 있어야 합니다.
type MatchRange = readonly [number, number]

type Suggestion = {
  id: string
  label: string
  value: string
  matches: readonly MatchRange[]
}

type SearchContext = {
  scopeKey: string
  locale: string
  corpus: string
  policyVersion: string
}

type SuggestionBatch = {
  query: string
  locale: string
  corpus: string
  indexVersion: string
  ttlMs: number
  items: readonly Suggestion[]
}

type View = {
  query: string
  phase:
    | "idle"
    | "composing"
    | "waiting"
    | "loading"
    | "ready"
    | "empty"
    | "error"
  items: readonly Suggestion[]
}

function normalizeQuery(raw: string) {
  return raw.normalize("NFC").trim()
}

function makeKey(query: string, context: SearchContext) {
  return JSON.stringify([
    context.scopeKey,
    context.locale,
    context.corpus,
    context.policyVersion,
    8,
    query
  ])
}label, 목록에 표시할 문자열입니다.
value, 선택했을 때 실제 검색에 사용할 값입니다. 표시 문자열에 부가 설명이 붙는 서비스에서는 두 값이 다를 수 있습니다.
matches, 강조할 구간입니다. 이번 계약에서는 원본 label의 UTF-16 위치를 사용하고 시작 위치는 포함하며 끝 위치는 포함하지 않습니다.
scopeKey, 브라우저 캐시를 계정과 세션 범위로 구분하기 위한 값입니다. 서버에 대한 인증 증명은 아닙니다.
corpus, 어떤 데이터 집합에서 후보를 찾는지 나타냅니다. 전체 검색과 특정 문서함 검색은 같은 입력이어도 결과가 다릅니다.
indexVersion, 서버가 후보를 만들 때 사용한 인덱스 버전입니다. 문자열의 사전순으로 최신 여부를 판단하는 용도로 사용하지 않습니다.
ttlMs, 이 결과를 클라이언트에서 재사용하도록 서버가 허용한 시간입니다. 인덱스 원본의 갱신 시점과는 별개입니다.
조회 상태와 목록의 열림 상태도 구분합니다
서버에서 후보를 받았다는 사실과 목록을 열어도 된다는 사실은 같지 않습니다.
사용자가 Escape를 누른 뒤라면 후보가 준비되어도 목록을 다시 열지 않아야 합니다.
입력창에서 포커스가 벗어나거나 검색을 제출한 경우도 마찬가지입니다.
따라서 실제 UI에는 현재 입력, 조합 여부, 목록 열림 여부, 활성 후보 ID와 조회 결과가 필요합니다. 하나의 isLoading만으로 모두 표현하지 않습니다.
결과가 없는 empty와 네트워크 오류인 error도 분리합니다. 오류를 빈 배열로 바꿔버리면 사용자는 후보가 없는 검색어라고 오해할 수 있습니다.
RDBMS에서 제외할 데이터
현재 입력 중인 문자열, 방향키로 선택한 후보, debounce 타이머와 요청 취소 객체는 브라우저의 일시적인 상태입니다.
입력 한 번마다 업무 DB에 행을 만들지 않습니다.
브라우저가 보관하는 후보 캐시도 서버 원본이 아닙니다. 최근 조회를 짧게 재사용하기 위한 복사본입니다.
서버에서는 검색 대상의 공개 상태, 검색 설정과 차단 정책처럼 변경의 정확성이 필요한 데이터를 원본 저장소에 둘 수 있습니다. 자동완성 요청마다 전체 원본을 읽기보다, 조회에 필요한 형태로 만든 검색 인덱스나 후보 캐시를 사용합니다.
선택과 노출 이벤트는 분석 경로로 보냅니다. 다만 사용자가 입력한 모든 중간 문자열을 수집해야 한다고 가정하지 않습니다. 미완성 입력에도 개인정보나 민감한 표현이 들어갈 수 있습니다.
서버 요청 로그에서도 검색어 원문을 기본적으로 남길지 별도의 정책이 필요합니다.
API Signatures
자동완성 API는 현재 입력에 대한 짧은 후보 목록을 반환합니다.
최종 검색을 실행하거나 사용자가 어떤 후보를 선택했다고 확정하는 API는 아닙니다.
GET /api/typeahead?q=rea&locale=ko-KR&corpus=public&limit=8 HTTP/1.1
Accept: application/json
X-Request-ID: req_17
HTTP/1.1 200 OK
Content-Type: application/json
Cache-Control: private, no-store{
"query": "rea",
"locale": "ko-KR",
"corpus": "public",
"indexVersion": "idx_203",
"ttlMs": 30000,
"items": [
{
"id": "suggestion_react",
"label": "react",
"value": "react",
"matches": [[0, 3]]
},
{
"id": "suggestion_react_hooks",
"label": "react hooks",
"value": "react hooks",
"matches": [[0, 3]]
}
]
}이번 계약에서는 브라우저가 정규화해 보낸 query를 응답에도 그대로 포함합니다. 서버 내부의 후보 검색 방식은 달라질 수 있지만, 어떤 입력에 대한 결과인지 클라이언트가 확인할 수 있어야 합니다.
HTTP 응답의 자동 캐시와 애플리케이션이 관리하는 세션 내 메모리 캐시는 별도의 정책입니다. 예제는 HTTP 캐시를 사용하지 않고, 허용된 후보 결과만 메모리에서 짧게 재사용합니다.
개인화나 비공개 데이터가 포함된다면 서버가 현재 인증과 권한을 확인해야 합니다. 브라우저가 전달한 scopeKey나 검색 범위를 권한으로 믿지 않습니다.
일반 검색은 자동완성 실패와 분리합니다
후보를 선택하지 않았더라도 사용자는 현재 검색어로 검색할 수 있습니다.
GET /search?q=react HTTP/1.1
Accept: text/html
자동완성 조회가 실패했다고 이 경로까지 막지 않습니다.
또 Enter를 눌렀을 때 아직 debounce 타이머가 남아 있다면 자동완성 결과를 기다렸다가 검색하지 않습니다. 현재 입력이나 사용자가 명시적으로 선택한 후보를 기준으로 바로 검색을 실행합니다.
요청 제한이 발생하면 서버는 이를 빈 후보 목록과 구분해서 반환합니다.
HTTP/1.1 429 Too Many Requests
Content-Type: application/json
Retry-After: 2

{
  "code": "SUGGESTION_RATE_LIMITED"
}
이 경우에는 이전 검색어를 자동으로 계속 재시도하지 않습니다. 제한 시간을 반영하고, 사용자가 현재 입력으로 일반 검색을 진행할 수 있게 합니다.
API 요청과 응답의 소유권
intentRevision은 서버 데이터의 버전이 아닙니다.
현재 검색창에서 어떤 사용자 의도가 유효한지 판단하는 로컬 번호입니다. 서버가 이 값을 믿고 권한을 결정하지도 않습니다.
응답을 받은 시점에 이 번호가 달라졌다면, 사용자가 이미 다른 입력이나 다른 행동으로 이동한 것입니다.
High-Level Design
입력 반영과 후보 조회를 분리합니다
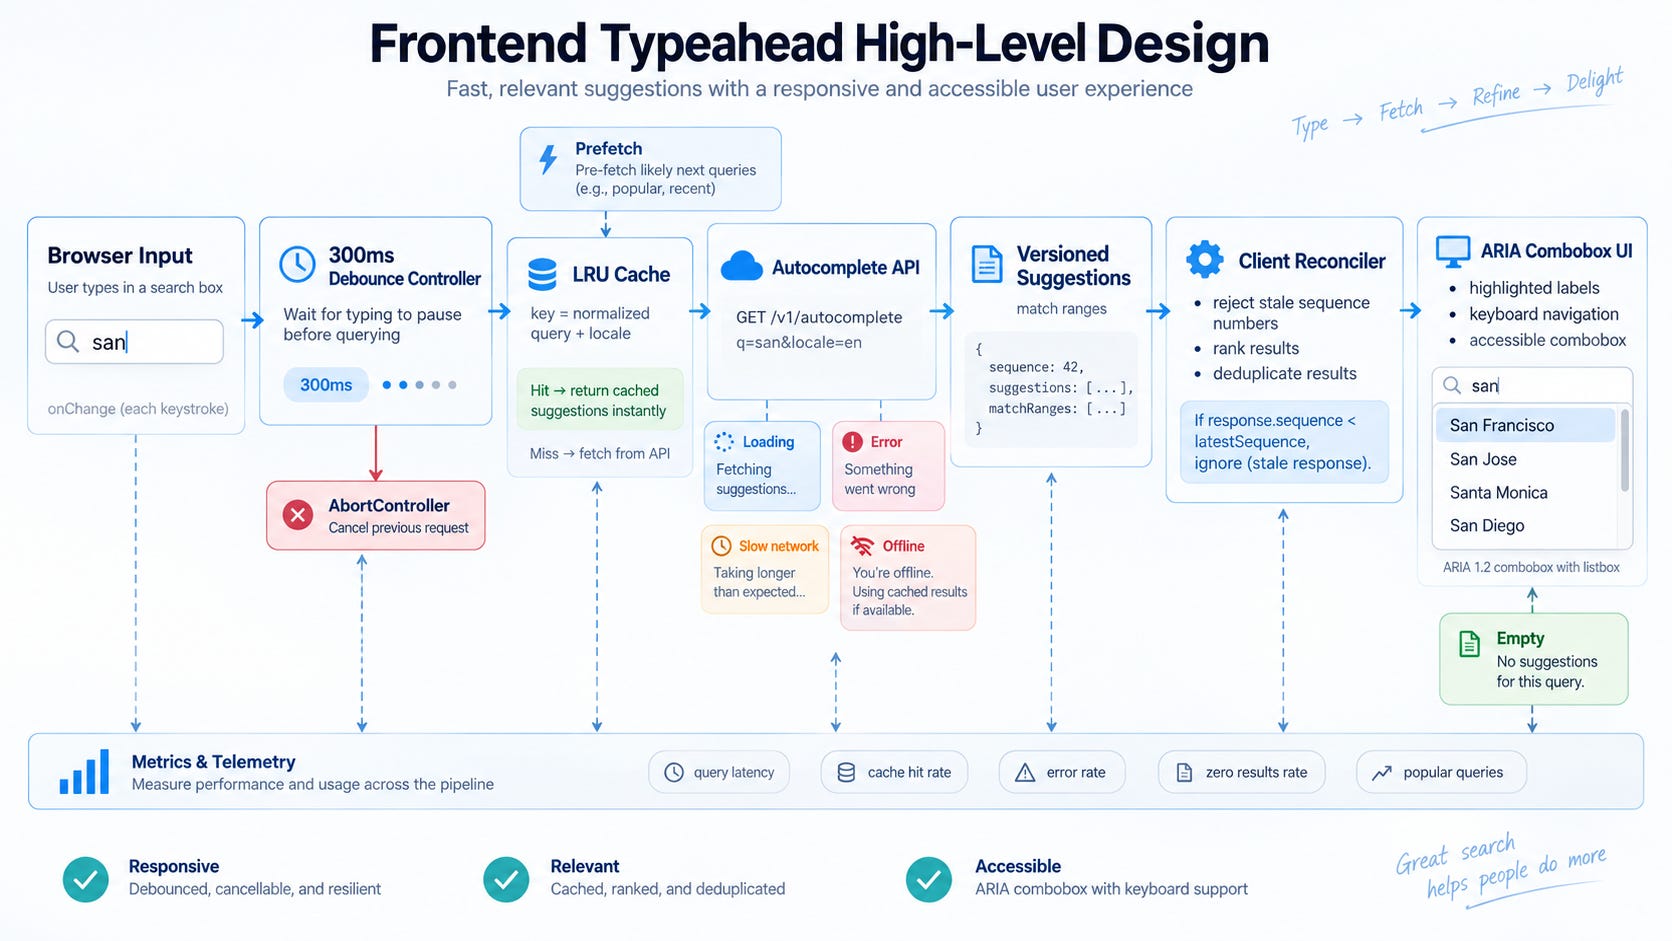
입력값은 네트워크와 관계없이 먼저 반영합니다.
Coordinator는 조합 중인지, 조회 가능한 길이인지, 캐시가 있는지 판단합니다. 네트워크가 필요한 경우에만 기다렸다가 요청합니다.
캐시 결과와 서버 결과 모두 현재 검색 문맥에 속하는지 확인한 뒤 화면에 반영합니다.
서버 내부의 조회 경로는 다음처럼 분리할 수 있습니다.
Suggestion API → Session and Policy Context, Request Limit → Candidate Retrieval (Prefix Index, Popular Query Cache, Allowed Personal History) → Deduplication, Ranking and Policy Filter → Top 8 Candidates, Labels and Match Ranges
전체 검색 대상에 무거운 처리를 적용하기 전에 접두사에 맞는 후보를 좁힙니다.
프론트엔드가 전체 사전과 인기 순위를 다운로드해 직접 검색하려고 하지 않습니다. 다만 선택지가 작고 거의 바뀌지 않는 국가 목록 같은 데이터라면 로컬 검색이 더 단순할 수 있습니다.
Deep Dive
자동완성의 성능 문제와 정확성 문제는 같은 도구 하나로 해결되지 않습니다.
debounce는 불필요한 요청을 줄입니다.
취소는 이미 필요 없어진 작업을 중단하도록 요청합니다.
현재 의도 검사는 늦게 도착한 결과가 화면을 바꾸지 못하게 합니다.
캐시는 같은 조회를 반복하지 않게 합니다.
이 역할을 분리해야 어느 도구가 빠져서 어떤 오류가 발생했는지 설명할 수 있습니다.
debounce와 throttle 중 무엇을 선택할까
사용자가 r, re, rea, react를 연속해서 입력한다고 해보겠습니다.